

昨天,我們利用真人訪談與小型問卷,把「我覺得大家需要」轉換成有證據的使用者需求。
然而,完成需求驗證後,團隊通常會遇到另一個陷阱:
每位組員都想到一個新功能,而且每個功能聽起來都很重要。
以「校園餐點助手」為例,功能清單可能迅速變成:
如果只有 8 週,4 位沒有完整開發經驗的大一生,這些功能真的能全部完成嗎?
更重要的是:
今天要將昨天取得的使用者證據,轉換成 User Story、驗收條件與功能優先級,最後切出真正做得完的 MVP。
MVP 是 Minimum Viable Product,常翻譯為「最小可行產品」。
初學者容易產生兩種誤解。
第一種是:
MVP 就是先做一個很醜、很多地方不能用的版本。
第二種是:
每個功能都先做 30%,加起來就是 MVP。
這兩種做法都可能得到一個不能完成任何任務的半成品。
對競賽專題而言,可以把 MVP 理解成:
使用者能走完一條核心流程,團隊也能藉此驗證最重要假設的最小版本。
例如,校園餐點助手的完整 MVP 流程可以是:
使用者輸入預算、位置及飲食限制
→ 系統從已查證資料中篩選選項
→ AI 或排序規則提供推薦
→ 使用者看到推薦理由與資料來源
→ 使用者選出一個可行餐點
第一版不一定需要:
只要核心使用者能完成最重要的任務,就有機會成為可以測試的 MVP。
昨天取得的訪談證據,不應該在開始開發後就被遺忘。
今天要建立以下追溯關係:
訪談證據
→ 使用者需求
→ User Story
→ 驗收條件
→ 功能優先級
→ MVP
→ Demo 測試
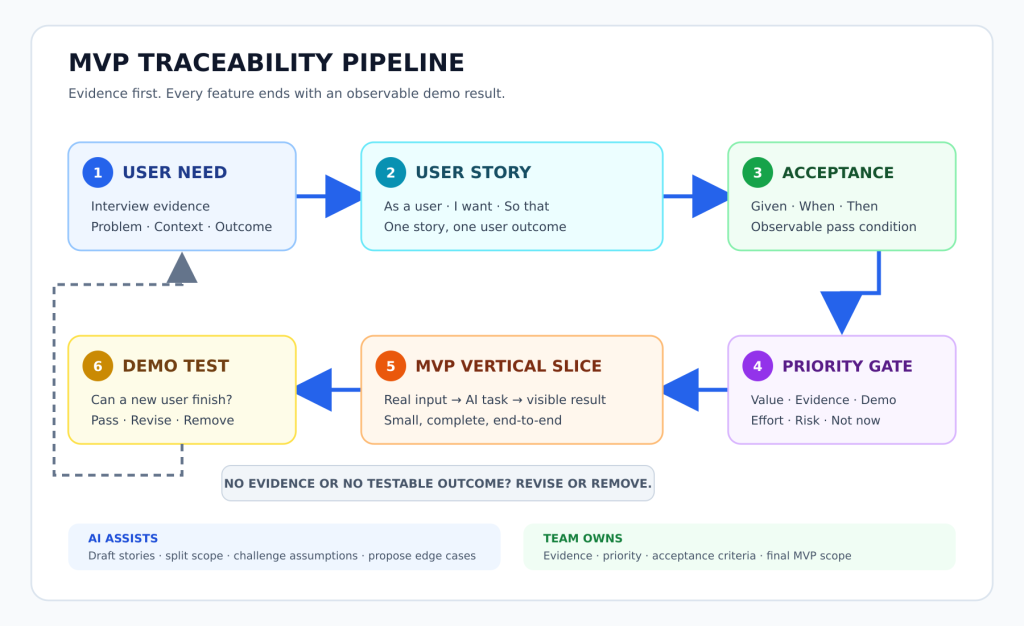
圖 1:MVP 需求追溯流程。每一項功能都必須連回使用者證據,並具備可觀察的驗收結果;通過優先級篩選後,組合成可由使用者完成的端到端 MVP,最後透過 Demo 測試決定保留、修改或移除。製作方式:依據 GOV.UK User Story 指南、Cucumber Gherkin 官方文件及 Atlassian 敏捷專案資料,自行繪製 SVG,再輸出為 1800×1100 PNG。
圖片替代文字:
使用者需求依序轉換成 User Story、驗收條件及功能優先級,再組合為 MVP 垂直切片並進行 Demo 測試;沒有證據或無法驗收的功能須返回修改或移除。
這條鏈能幫助團隊回答評審很常問的問題:
為什麼要做這個功能?
比較弱的回答是:
因為我們覺得大家應該會喜歡。
比較完整的回答是:
在五位受訪者中,有三位提到晚上使用地圖搜尋店家時,曾遇到營業資訊不準確。因此第一版優先提供具來源時間的營業狀態,並把「能在 30 秒內找到一個仍營業的選項」設定為驗收條件。
這四個概念很容易混在一起。
| 類型 | 要回答的問題 | 範例 |
|---|---|---|
| 使用者需求 | 使用者想完成什麼? | 晚上留校時,需要快速找到符合條件的餐點 |
| User Story | 哪類使用者要完成哪個目標? | 作為晚上留校的學生,我希望依預算及飲食限制篩選餐點 |
| 功能 | 系統提供什麼能力? | 預算與飲食條件篩選 |
| 工作任務 | 團隊要做什麼? | 建立篩選表單、設計資料欄位、撰寫測試 |
不能把工作任務寫成 User Story:
作為開發者,我想建立資料庫。
這描述的是團隊要做的事情,沒有表達使用者價值。
也不建議直接寫:
使用者需要一個 AI 聊天機器人。
「聊天機器人」是一種解法。應先確認使用者到底想完成什麼。
GOV.UK 的服務設計指南將 User Story 整理為三個核心部分:
常見格式是:
作為【某類使用者】,
我希望【完成某項行動】,
以便【得到某個結果】。
例如:
作為晚上留校且有飲食限制的學生,
我希望依預算、距離及飲食條件篩選仍在營業的餐點,
以便不用逐間前往確認。
一則好的 User Story 應該:
可以將昨天的需求卡與證據表交給 AI:
你是一位協助大學生規劃 AI 專題的產品教練。

以下是經過真人訪談整理的需求與證據:

【使用者需求】
作為晚上留校的學生,
當我臨時需要尋找晚餐時,
我需要快速確認附近仍在營業且符合飲食條件的餐點,
以便不用逐間前往確認。

【訪談證據】
E01:P01 使用地圖前往店家,到達後才發現已打烊。
E02:P02 因為不想花時間尋找,最後直接前往便利商店。
E03:P03 有素食需求,需要逐間查看菜單。
E04:P04 表示自己通常晚上六點前離校,沒有遇過這個問題。

【任務】
請將需求拆成候選 User Stories。

【要求】
1. 每則故事使用「作為/我希望/以便」格式。
2. 每則故事只能描述一個可觀察的使用者目標。
3. 每則故事必須標示支持它的證據編號。
4. 沒有證據支持的構想,標示為「待驗證」,不要寫成確定需求。
5. 不要自行加入帳號、付款、評論、社群或推播功能。
6. 如果故事太大,請拆成能單獨測試的小故事。
7. 保留 E04 這類反例,不要只選支持專題的證據。

請以表格輸出:
- Story ID
- User Story
- 證據編號
- 預期價值
- 仍需確認的問題
AI 可以幫助整理,但團隊需要逐項確認:
只有 User Story,仍然不容易判斷功能是否完成。
例如:
作為學生,我希望快速找到餐點。
「快速」到底是幾秒?
「找到」代表顯示一個店名,還是需要符合預算、距離與飲食限制?
因此,每則 User Story 都需要驗收條件。
GOV.UK 將驗收條件描述為用來確認服務是否完成任務、滿足需求的結果清單。Cucumber 的 Gherkin 規格則常使用:
Given:已知的初始情境
When:使用者執行的動作
Then:應該觀察到的結果
中文可以寫成:
假設……
當……
那麼……
User Story:
作為晚上留校且有素食需求的學生,
我希望依預算、距離及飲食條件搜尋餐點,
以便快速找到可以前往的選項。
驗收條件:
情境一:有符合條件的餐點

假設使用者的位置在校門口,
而且設定預算上限為 100 元、步行時間為 15 分鐘、飲食條件為素食,
當使用者執行搜尋,
那麼結果只能顯示符合三項限制的餐點,
而且每筆結果都要顯示價格、距離、營業狀態及資料更新時間。
情境二:沒有符合條件的餐點

假設目前資料中沒有同時符合所有條件的餐點,
當使用者執行搜尋,
那麼系統應清楚顯示「目前找不到完全符合的選項」,
並提供可放寬的條件,
不能自行捏造不存在的店家或餐點。
情境三:資料來源無法取得

假設外部資料來源暫時無法連線,
當使用者執行搜尋,
那麼系統應標示資料暫時無法更新,
顯示最後更新時間,
而不是把過期資料包裝成即時結果。
這三組情境分別測試:
對 AI 專題而言,後兩項特別重要。很多 Demo 只準備「剛好成功」的資料,卻沒有處理 AI 找不到答案或外部服務中斷的情況。
可以使用:
請檢查以下 User Story 與驗收條件是否可以由另一位組員實際測試。

請找出:
1. 「快速、智慧、方便、準確、友善」等無法直接測量的形容詞。
2. 缺少輸入條件的情境。
3. 沒有明確預期結果的情境。
4. 只檢查正常流程、沒有失敗流程的故事。
5. 依賴 AI 主觀判斷,但沒有評估標準的結果。
6. 無法連回使用者證據的功能。
7. 一次包含太多功能的故事。

請將每一項問題改寫成可以觀察、記錄或比較的驗收條件。
如果無法驗收,請說明缺少什麼資訊,不要自行假設。
不夠明確:
AI 推薦要很準確。
較可驗收:
在 20 組已人工標記的測試情境中,
系統前 3 名推薦至少有 16 組包含一個符合所有硬性限制的選項。
任何不符合預算或飲食限制的項目都不能被列為可行結果。
這裡同時區分了:
以下故事太大:
作為學生,我希望獲得完整且個人化的校園餐飲服務,
以便解決所有用餐問題。
它可能同時包含搜尋、推薦、地圖、通知、帳號、付款及評論。
可以依使用流程拆分:
也可以要求 AI 協助拆分:
以下 User Story 在 1 週內無法完成。

請將它拆成數則可以獨立展示與驗收的小故事。

拆分規則:
1. 每則故事只產生一個主要使用者結果。
2. 不可以只按前端、後端、資料庫等技術層拆分。
3. 每則故事都要能單獨測試。
4. 標示故事之間的依賴關係。
5. 找出最小但完整的端到端流程。
6. 不要新增原故事沒有的使用者需求。

請輸出:
- 子故事 ID
- User Story
- 驗收結果
- 前置依賴
- 是否能單獨 Demo
重點是依「使用者能完成什麼」拆分,而不是:
這種分層開發可能讓每個部分都完成了一些,卻沒有任何一條流程能真正運作。
Backlog 可以理解為「尚未完成、已排序的工作清單」。
對大一生團隊來說,不一定要立刻學習複雜的專案管理平台。一張共用試算表就足夠開始。
建議欄位:
| 欄位 | 用途 |
|---|---|
| Story ID | 故事編號,例如 US-001 |
| User Story | 使用者、行動及目標 |
| Evidence | 訪談或問卷證據編號 |
| Acceptance | 驗收條件連結 |
| User Value | 對使用者的價值 |
| Evidence Strength | 證據強度 |
| Demo Value | 是否適合競賽展示 |
| Effort | 預估實作成本 |
| Risk | 技術、資料或外部依賴風險 |
| Priority | Must、Should、Could、Not now |
| Owner | 負責人 |
| Status | 待處理、進行中、待測試、完成 |
故事清單可以放在:
工具不是重點。無論使用哪一種,都必須讓全組看到:
不要直接問 AI:
哪個功能最重要?
AI 不知道你們的時程、能力、資料及競賽規則,很可能只是依照一般產品經驗排序。
可以從五個角度評估,每項給 1~5 分:
完成後,是否能直接改善已驗證的問題?
有多少訪談、問卷或觀察資料支持?
能否在競賽現場清楚展示「輸入、AI 處理及結果」?
團隊需要多少時間、技術及整合工作?
是否依賴不穩定 API、難以取得的資料、付費服務或尚未掌握的技術?
可以使用以下簡化公式:
優先分數
= 2 × 使用者價值
+ 證據強度
+ 展示價值
- 實作成本
- 風險
這是本系列為學生專題設計的相對排序工具,不是通用產業標準,也不能取代團隊討論。
使用者價值乘以 2,是為了避免「很炫但沒有需求」的功能排到最前面。
| 候選功能 | 價值 | 證據 | Demo | 成本 | 風險 | 分數 |
|---|---|---|---|---|---|---|
| 依硬性條件篩選餐點 | 5 | 5 | 5 | 2 | 2 | 16 |
| 顯示推薦理由與來源 | 5 | 4 | 5 | 3 | 2 | 14 |
| 依價格或距離排序 | 4 | 4 | 4 | 2 | 1 | 13 |
| 個人化 AI 推薦 | 4 | 2 | 5 | 5 | 4 | 6 |
| 店家推播通知 | 3 | 2 | 3 | 4 | 4 | 3 |
| 社群貼文分享 | 1 | 1 | 2 | 2 | 1 | 2 |
| 線上付款 | 2 | 1 | 3 | 5 | 5 | -2 |
分數不是自動決策,而是讓團隊看見:
可以讓 AI 檢查排序:
以下是我們的 AI 專題候選功能、證據及評分。

請不要直接替我們決定要做哪些功能。

請執行:
1. 檢查每項分數是否與附上的證據一致。
2. 找出可能被高估的使用者價值。
3. 找出可能被低估的開發成本或外部依賴。
4. 找出只是展示炫技、但不能解決核心問題的功能。
5. 找出缺少資料、無法合理評分的功能。
6. 提出三種 MVP 組合:
   - 最低風險版本
   - 最佳競賽展示版本
   - 最強使用者價值版本
7. 說明每種組合必須放棄什麼。

規則:
- 不得捏造使用者證據。
- 無法判斷時標示「需要團隊確認」。
- 最終選擇權由團隊保留。
AI 最適合幫助團隊發現盲點,而不是扮演唯一的產品經理。
完成評分後,將功能分成四類。
例如:
例如:
例如:
例如:
「Not now」不是承認失敗,而是保護團隊的完成度。
專題最危險的情況不是功能少,而是沒有任何人敢說:
這個功能先不做。
對每項候選功能詢問:
例如:
帳號登入是不是 Must?
如果核心任務只是讓使用者輸入條件並取得推薦,第一版可能不需要帳號。
顯示資料更新時間是不是 Must?
如果專題承諾提供仍在營業的餐點,資料時間會直接影響可信度,因此可能是 Must。
Must 不是技術上最困難的功能,而是移除後會破壞核心價值的功能。
垂直切片是指一條從輸入到結果都能運作的完整流程。
校園餐點助手的第一條切片可以是:
真實使用者情境:
晚上七點,學生只有 100 元,步行時間最多 15 分鐘,而且需要素食。

輸入:
預算、位置、時間及飲食限制。

資料:
10~20 筆已查證的校園周邊餐點資料。

處理:
先排除違反硬性限制的選項,
再依價格、距離及營業狀態排序。

AI 任務:
根據結構化候選結果,用簡短文字說明前 3 名推薦理由。
AI 不得重新加入已被硬性限制排除的選項。

輸出:
顯示餐點、價格、距離、營業狀態、推薦理由、資料來源及更新時間。

驗收:
使用者能在 30 秒內選出一個符合所有硬性限制的選項。
這條流程同時包含:
它可能沒有登入、付款及推播,卻已能證明專題的核心價值。
不要為了參加 AI 競賽,就把每一個步驟都交給生成式 AI。
可以拆成:
硬性限制:
由程式規則處理
例如預算、距離、飲食禁忌、營業狀態

軟性偏好:
由排序模型或 AI 協助
例如偏好安靜、份量、CP 值、推薦理由

自然語言:
由生成式 AI 處理
例如將使用者描述轉成條件、解釋推薦原因
錯誤做法:
直接把所有店家資料交給 AI,叫它自由選三間。
較可靠的做法:
程式先排除不符合硬性限制的候選,
再讓 AI 針對剩餘候選進行比較與說明。
這樣即使 AI 的文字不夠完美,也比較不容易推薦超出預算、違反飲食限制或已經停止營業的選項。
不一定要等網站完成後才測試流程。
可以先準備三張紙或三個簡報畫面:
請一位沒有參與專題的同學操作,觀察:
如果紙上流程都無法理解,寫成程式通常也不會自動變清楚。
至少準備三種情境。
預算:100 元
距離:步行 15 分鐘
飲食:不限
預期:顯示至少一個符合限制的選項
預算:30 元
距離:步行 3 分鐘
飲食:素食
預期:清楚顯示沒有符合選項,不得捏造結果
情境:外部資料或 AI 暫時無法連線
預期:
- 顯示錯誤狀態
- 保留使用者輸入
- 不將舊資料冒充即時資料
- 提供重試或替代流程
競賽 Demo 最容易出問題的,往往不是主要功能,而是網路、API、資料與帳號。
越早測試失敗情境,現場越不容易慌張。
如果超過一半的功能都是 Must,代表團隊還沒有真正排序。
Must 應只保留:
缺少它,核心使用者就無法完成主要任務的項目。
不合格:
改成可測量的結果:
如果團隊分工是:
很可能到最後才發現資料格式、API 及畫面對不起來。
較好的方式是先合作完成一條垂直切片:
一個輸入頁面
+一小份真實資料
+一項 AI 任務
+一個結果頁面
+一組驗收測試
確認能運作後,再擴充第二條流程。
AI 可以協助列出可能工作,但它不知道:
因此,AI 說「兩天即可完成」,不代表團隊真的能在兩天內完成。
比較安全的做法是:
團隊應正式保存:
本次 MVP 不包含:
- 線上付款
- 社群評論
- 跨校區即時資料
- 自行訓練大型語言模型
- 長期個人化推薦
評審詢問時,可以說明:
我們根據使用者證據、八週時程及技術風險,優先完成可查證的搜尋與推薦流程。付款與評論不是目前核心需求,因此列入後續版本。
這比回答「因為來不及」更能展現專題規劃能力。
| 驗收項目 | 合格標準 |
|---|---|
| 需求可追溯 | 每則 Must Story 都有訪談或問卷證據 |
| 格式完整 | Story 包含使用者、行動及目標 |
| 範圍適中 | 單一 Story 能在短週期完成 |
| 可以驗收 | 有明確輸入、動作與可觀察結果 |
| 包含失敗情境 | 不只有正常流程 |
| 排序透明 | 分數與分類有可說明的理由 |
| Must 足夠少 | 只保留核心流程必要項目 |
| 有不做清單 | 明確列出本版本排除範圍 |
| AI 任務明確 | 能說明 AI 的輸入、處理與輸出 |
| 有端到端流程 | 使用者可以走完一條完整任務 |
| 能夠 Demo | 五分鐘內可展示問題、操作及結果 |
| 有替代方案 | 外部服務失敗時仍有處理方式 |
每則都要包含:
Story ID:
作為:
我希望:
以便:
支持證據:
至少包含:
格式:
假設……
當……
那麼……
至少評估:
Must:
Should:
Could:
Not now:
真實使用情境
→ 使用者輸入
→ 資料來源
→ 程式或 AI 處理
→ 使用者看見的結果
→ 驗收標準
今天的完成條件不是列出最多功能,而是全組能回答:
如果只剩兩週,我們仍然會保留哪一條完整流程?為什麼?
從使用者需求到 MVP,應該保留完整追溯關係:
需求有真人證據
→ User Story 說明使用者價值
→ 驗收條件定義完成標準
→ 優先級決定開發順序
→ MVP 提供端到端核心流程
→ Demo 測試驗證實際成果
AI 可以協助:
但 MVP 的範圍仍必須由團隊決定。
真正有競爭力的專題,通常不是功能最多,而是能把一個重要問題解決得完整、可信且可驗收。
Day 7,我們將為 MVP 建立資料規格:學習 CSV、JSON、欄位設計、資料字典及清理規則,避免網站、AI 與組員各自使用不同格式,最後整合不起來。
以上資料於 2026 年 9 月 20 日查閱。本文的優先分數公式是為學生專題設計的簡化比較工具,不屬於 Scrum、Gherkin 或其他框架的官方規範。


 iThome鐵人賽
 看影片追技術